一、引言
人工智能(Artificial Intelligence, AI)自1956年達特茅斯會議提出以來,已經走過了近七十年的發展歷程。從早期的符號主義到如今的深度學習,AI技術不斷突破,深刻改變了人類社會的生產生活方式。掌握人工智能基礎專業理論知識,具備AI技術應用開發能力,并能夠從事人工智能理論與算法軟件開發,已成為當今信息技術領域高層次人才的核心素養。本文將圍繞人工智能的理論基礎、應用技術開發以及算法軟件工程實踐三個方面展開論述,旨在為讀者構建一個從理論到落地的完整知識框架。
二、人工智能基礎專業理論
2.1 數學基礎
人工智能的理論根基建立在數學之上,主要包括:
- 線性代數:向量、矩陣、張量運算,特征值分解,奇異值分解等,是神經網絡前向傳播和反向傳播的數學語言。
- 概率論與數理統計:貝葉斯理論反應了不確定性推理,極大似然估計、最小二乘法等是模型參數估計的基石。
- 微積分與優化理論:梯度下降、牛頓法、凸優化等,是訓練模型的核心工具。
- 信息論:熵、互信息、KL散度等,用于衡量分布差異與特征選擇。
2.2 核心理論體系
- 機器學習:監督學習(分類、回歸)、無監督學習(聚類、降維)、半監督學習、強化學習等。經典算法包括SVM、決策樹、隨機森林、K-Means等。
- 深度學習:多層感知機、卷積神經網絡(CNN)、循環神經網絡(RNN)、Transformer、生成對抗網絡(GAN)等。
- 知識表示與推理:一階邏輯、描述邏輯、知識圖譜、本體論等,支撐符號主義與連接主義的融合。
- 搜索與規劃:A*算法、蒙特卡洛樹搜索、強化學習中的策略迭代與值迭代等。
2.3 認知科學與神經科學啟示
人工智能的許多思想源于對生物智能的模擬。例如,卷積神經網絡的感受野機制受視覺皮層啟發,注意力機制借鑒了人類認知的選擇性注意。理解這些交叉學科知識有助于設計更魯棒、更通用的AI系統。
三、人工智能應用技術開發
3.1 計算機視覺
計算機視覺使機器能夠“看懂”圖像和視頻。典型應用包括:
- 圖像分類(ResNet、EfficientNet)
- 目標檢測(YOLO、Faster R-CNN)
- 語義分割(U-Net、DeepLab)
- 人臉識別(FaceNet、ArcFace)
- 三維重建與SLAM
開發這類應用需要掌握OpenCV、PyTorch、TensorFlow等框架,并具備數據增強、遷移學習、模型壓縮等工程能力。
3.2 自然語言處理
NLP讓機器理解并生成人類語言。核心技術有:
- 詞向量(Word2Vec、GloVe)
- 預訓練語言模型(BERT、GPT、T5)
- 序列標注、機器翻譯、問答系統、情感分析
- 大語言模型(LLM)的微調與提示工程
應用開發涉及Hugging Face Transformers、LangChain等工具,需處理分詞、嵌入、注意力機制及部署優化。
3.3 語音與音頻處理
語音識別(ASR)、語音合成(TTS)、聲紋識別等技術已廣泛落地。常用模型包括DeepSpeech、Tacotron、WaveNet,以及端到端的Conformer、Whisper等。
3.4 強化學習與決策智能
強化學習在游戲(AlphaGo)、機器人控制、自動駕駛、推薦系統中表現突出。開發要點包括環境建模、獎勵設計、策略梯度、DDPG、PPO等算法實現。
3.5 推薦系統與知識圖譜應用
推薦系統利用協同過濾、矩陣分解、深度學習排序模型(如Wide & Deep、DIN)為用戶提供個性化內容。知識圖譜則用于構建實體關系,支撐智能搜索和問答。
四、人工智能理論與算法軟件開發
4.1 算法軟件工程特點
AI算法軟件與傳統的業務軟件不同,具有以下特征:
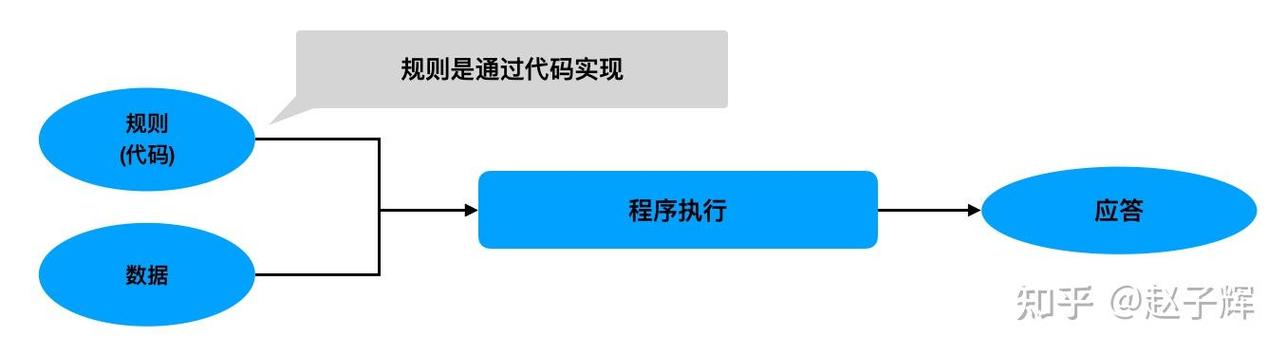
- 數據依賴性:模型性能高度依賴訓練數據規模與質量。
- 計算密集型:需要GPU、TPU等加速硬件,并考慮分布式訓練。
- 迭代開發:實驗驅動,需要快速原型與A/B測試。
- 非確定性:隨機初始化、超參數、數據順序等導致結果波動。
4.2 開發流程與工具鏈
完整的AI軟件開發生命周期包括:
- 問題定義與數據準備:數據采集、清洗、標注、特征工程。
- 模型設計與訓練:選擇算法、搭建網絡、損失函數、優化器、訓練調參。
- 評估與驗證:交叉驗證、混淆矩陣、ROC-AUC、BLEU、mAP等指標。
- 部署與監控:模型轉換(ONNX、TensorRT)、服務化(TensorFlow Serving、TorchServe)、在線推理與持續監控。
- 迭代優化:收集線上反饋,進行增量學習或重新訓練,持續集成/持續部署(CI/CD)。
常用工具體系:
- 框架:PyTorch、TensorFlow、JAX、PaddlePaddle
- 實驗管理:MLflow、Weights & Biases、TensorBoard
- 數據版本控制:DVC、Git LFS
- 模型部署:Docker、Kubernetes、Kubeflow、ONNX Runtime
- 高性能計算:CUDA、cuDNN、NCCL、Horovod
4.3 算法軟件設計模式與最佳實踐
- 模塊化:將數據加載、模型定義、訓練循環、評估指標解耦。
- 配置驅動:使用YAML/JSON管理超參數,便于重現實驗。
- 可復現性:固定隨機種子,記錄環境依賴與代碼版本。
- 性能優化:混合精度訓練、梯度累積、算子融合、模型剪枝與量化。
- 倫理與安全:防止偏見、對抗攻擊、隱私泄露,推廣負責任AI。
4.4 案例:從零構建一個圖像分類算法軟件
以一個細粒度圖像分類任務為例,演示工程落地:
- 數據:使用ImageNet子集,進行數據增強(隨機裁剪、翻轉、MixUp)。
- 模型:基于EfficientNet-B0遷移學習,修改分類層。
- 訓練:使用PyTorch Lightning,AdamW優化器,余弦退火調度。
- 部署:導出ONNX模型,利用ONNX Runtime在CPU/GPU上推理,或者使用Triton Inference Server提供HTTP/gRPC接口。
- 監控:記錄延遲、吞吐量、準確率漂移。綜上,AI算法軟件開發不僅是寫代碼,更是理解數據、模型與系統的系統性工程。
五、挑戰與未來展望
當前,AI理論與算法軟件開發面臨多重挑戰:
- 可解釋性:深度模型的黑箱特性限制了其在醫療、金融等關鍵領域的應用。
- 數據效率:如何用更少樣本學習(小樣本、零樣本)。
- 泛化與魯棒性:分布外檢測、對抗魯棒性。
- 能耗與綠色AI:大模型訓練碳排放巨大,需要高效架構與硬件協同設計。
- 多模態融合:文本、圖像、語音、視頻的統一表示與推理。
未來趨勢包括:自監督學習、神經符號混合、具身智能、AI for Science、大模型輕量化與邊緣部署。掌握基礎理論、應用技術與算法軟件開發的復合型人才,將在這些方向上大有可為。
六、
人工智能不是單一的算法或工具,而是一個從數學理論到工程實踐的綜合體系。只有扎實掌握專業理論知識,熟練運用應用技術,并具備算法軟件開發的工程素養,才能應對真實世界的復雜問題。希望本文能為有志于AI研究與應用開發的讀者提供一份清晰的路線圖,助力大家在人工智能的浪潮中行穩致遠。